הפוקוס מתבקש: משימות ארוכות שרצות לבד. הוא מתמודד עם עבודה ממושכת בצורה קפדנית יותר, עוקב אחרי הוראות בדיוק גבוה, ומאמת את הפלטים של עצמו לפני שהוא חוזר אליכם. בקיצור, אפשר להעביר לו את העבודה הקשה עם הרבה פחות בייביסיטר. הכל כמובן לטענת אנתרופיק. מוזמנים לוודא..
מה חדש:
- ראייה משופרת. רואה תמונות ברזולוציה גבוהה פי 3, ומייצר ממשקים, מצגות ומסמכים באיכות טובה יותר.
- ב-API יש רמת מאמץ חדשה, xhigh, שיושבת בין high ל-max. נותנת שליטה עדינה יותר על reasoning ו-latency במשימות קשות. בנוסף, Task budgets (בטא) עוזרים לקלוד לתעדף עבודה ולנהל עלויות ב-runs ארוכים.
- ב-Claude Code: פקודה חדשה /ultrareview, סשן ביקורת ייעודי שעובר על השינויים שלכם ומסמן מה שמבקר קוד קפדני היה תופס. auto mode נפתח גם למשתמשי Max, ככה שמשימות ארוכות רצות עם פחות הפרעות.
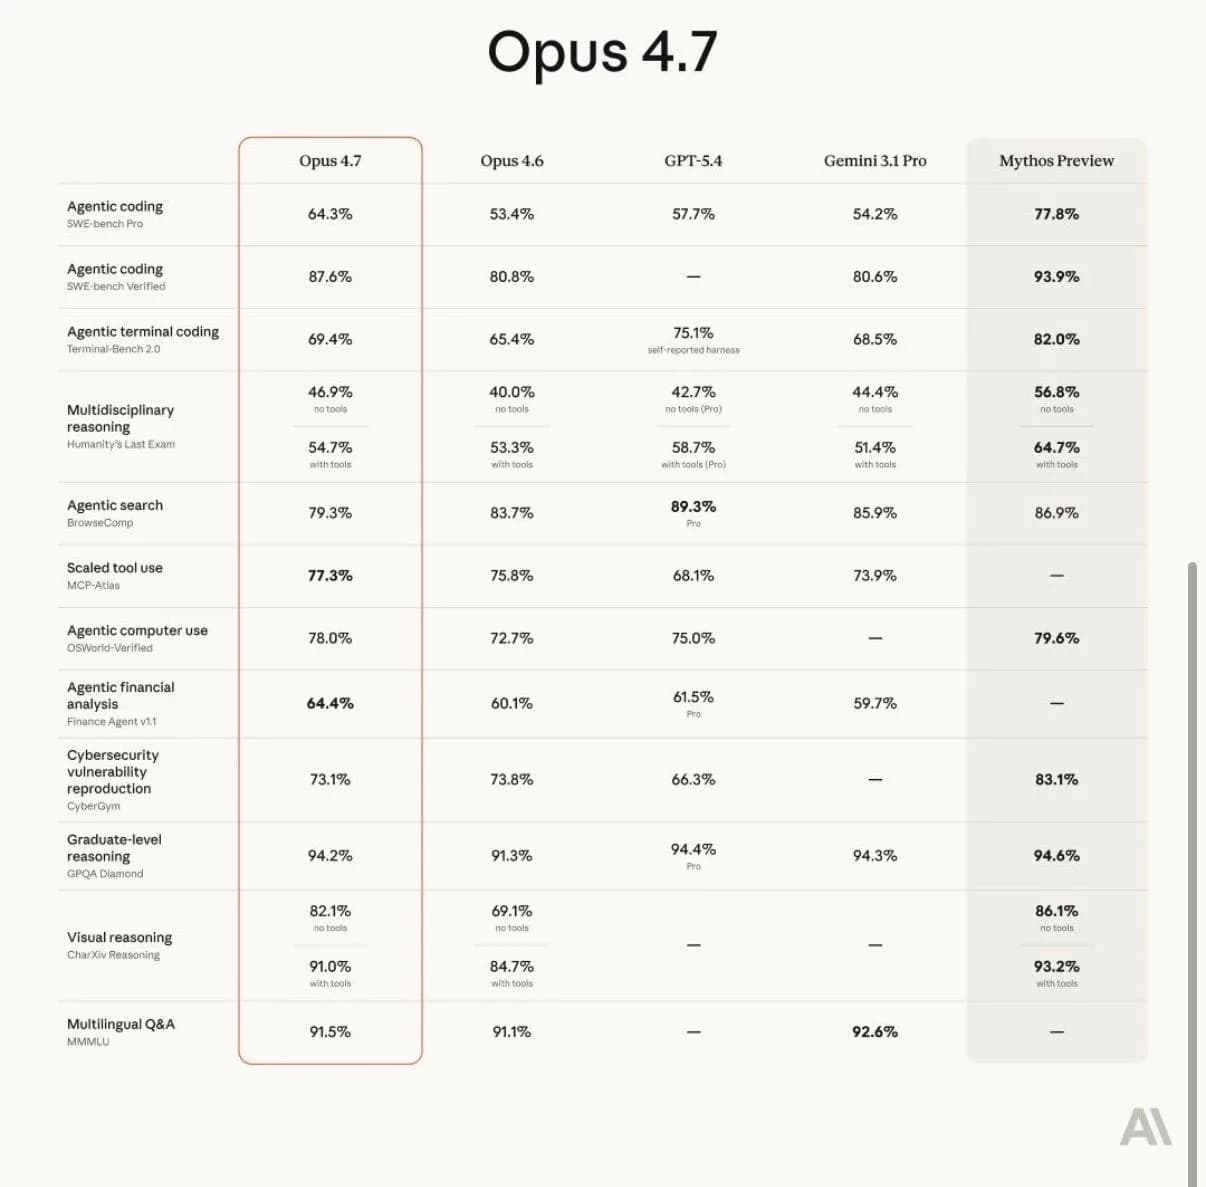
- ביצועים מול Opus 4.6: SWE-bench Pro: 64.3% (לעומת 53.4%), קפיצה של כ-11 נקודות. SWE-bench Verified: 87.6% (לעומת 80.8%). Terminal-Bench 2.0: 69.4%. MCP-Atlas: 77.3%, המוביל בבנצ'מרק הזה. OSWorld-Verified: 78.0%. GPQA Diamond: 94.2%.
הסיפור האמיתי פה הוא agentic coding. הקפיצה ב-SWE-bench Pro היא ההפרש הכי משמעותי בטבלה, וזה בדיוק מה שמרגישים בשימוש יומיומי ב-Claude Code.
הערה אחת לאיזון: בטבלה מופיע גם Mythos Preview שעוקף את 4.7 כמעט בכל בנצ'מרק. כלומר אנתרופיק כבר מראים מה בא אחרי. 4.7 הוא שיפור מוצק, לא קפיצה דרמטית, אבל בעבודה האמיתית ההבדלים מצטברים.
כמה זה עזר לכם?
טרם דורג — היו הראשונים
התחברו עם Google כדי לדרג